本文已收录在合集数据系统经典论文阅读中.
本文是对Databricks的Lakehouse(湖仓一体)论文(Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics)的阅读总结. 论文详细阐述了需要Lakehouse的原因, Lakehouse的具体架构以及在Lakehouse构建中可进一步探索的研究性问题. 通过阅读论文可以更深刻地了解Lakehouse产生的前因后果, 从而更加客观地看待这一新兴数据平台架构.
本文不会对论文进行完整的翻译, 而是按如下主线剖析论文的核心观点和内容, 并穿插笔者的见解:
- 现有的数据平台架构及存在的问题.
- 支撑Lakehouse成功的必备技术条件.
- Lakehouse的架构及特性.
现有数据平台及问题
第一代数据平台
数据仓库(Data Warehouse)起源于上世纪80年代, 它将分散在各个业务数据库中的数据, 采集传输到集中的数据仓库中, 以帮助企业领导者获得分析见解, 这些数据仓库还可进一步用于决策支持和商业智能(BI).
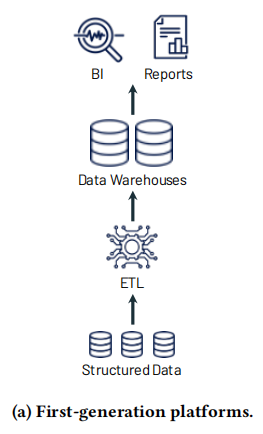
第一代数据平台主要用于构建数据仓库, 其处理流程如下图所示. 包含在业务数据库(一般是关系型数据库)中的结构化数据通过ETL导入到数据仓库系统中. 数据仓库中的数据将使用写时模式(Schema-on-write)写入, 这确保了数据模型针对下游BI消费进行了优化.
随着数据量的增长, 第一代数据平台出现了一些问题(以下是论文原话的翻译):
- 首先, 它们通常将计算和存储耦合到本地设备中. 这迫使企业为峰值用户负载和受管理的数据进行调配和付费, 随着数据集的增长, 这变得非常昂贵.
- 其次, 不仅数据集在快速增长, 而且越来越多的数据集完全是非结构化的, 例如视频, 音频和文本文档, 难以在数据仓库中存储和查询.
实际上, 对于第一点笔者认为论文的描述并不完全准确, 数据仓库的实现技术也在不断发展. 在初期的小数据量时代, 数据仓库的实现系统一般以传统的关系型数据库为主, Oracle等厂商也有商用的数据仓库系统, 不过它们大多采用集中式架构. 这确实使得横向扩展困难, 当数据量增大而出现性能问题时, 只能纵向扩展底层系统资源, 需要昂贵的成本. 但是随着数据量的不算增长, MPP架构的出现使得廉价处理更大的数据集成为可能, 当前仍有广泛使用的MPP数据仓库, 如Greenplum, Clickhouse等. 另外, 随着云计算技术的发展, 云原生数据仓库的出现也为低成本地处理大规模数据提供了解决方案, 如AWS的Redshift, 阿里云的AnalyticDB等. 因此, 使用当前最先进的数据仓库系统在大规模数据集下不一定会有多么昂贵的成本, 不过这些数据仓库系统基本上只能处理结构化数据, 确实难以用于半结构化或非结构化数据的处理.
第二代数据平台
由于第一代数据平台的上述问题, 在2010年前后, 第二代数据平台开始出现.
在这一架构中, 所有的原始数据都会被导入到统一的数据湖中. 数据湖是具有文件API的低成本存储系统, 以通用且开放的文件格式保存数据, 如Apache Parquet和ORC. 之后, 数据湖中的一部分数据可进一步被ETL到下游的数据仓库系统中, 用于最重要的决策支持和BI应用. 另外, 开放格式的使用也使得数据湖中的数据可以被其他各种分析引擎直接访问, 例如机器学习系统. 其处理流程如下图所示.
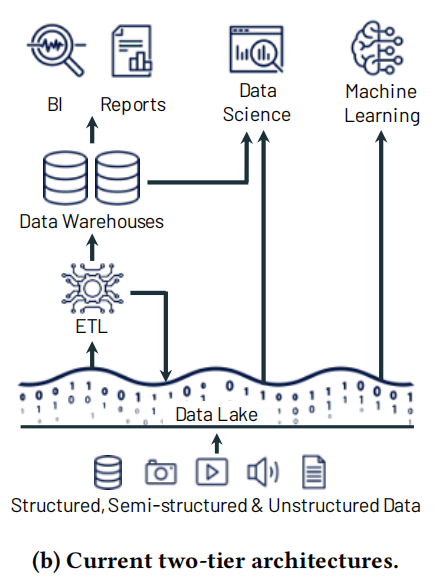
数据湖最开始一般使用Apache Hadoop的HDFS进行存储, 不过近来随着云存储(如AWS S3, 阿里云OSS)的发展, 逐渐取代了HDFS. 主要是由于它们具有卓越的持久性(通常大于10个9), 异地多副本等特点, 最重要的是成本极低, 可以自动进行更廉价的分层存储.
数据湖是一种读时模式(Schema-on-read)架构, 它支持以低成本灵活地存储任何数据, 但另一方面, 将数据质量和治理问题放在了下游.
表面上来看, 第二代数据平台可以将存储和计算分离, 从而降低成本, 但其仍然存在问题(以下是论文原话的翻译).
- 可靠性(Reliability). 保持数据湖和数据仓库的一致性既困难又昂贵. 需要持续在两个系统之间进行ETL, 使其可用于高性能决策支持和BI. 每个ETL步骤也有招致失败或引入降低数据质量的错误的风险, 例如, 由于数据湖和数据仓库引擎之间的细微差别而引起的.
- 数据陈旧(Data staleness). 与数据湖中的数据相比, 数据仓库中的数据是陈旧的, 新数据经常需要几天才能加载. 与第一代数据平台架构相比这是一种倒退, 在第一代数据平台中, 新的业务数据可以立即用于查询. 根据Dimensional Research和Five-tran的调查, 86%的分析师使用过时的数据, 62%的分析师报告每月要等待工程资源多次.
- 对高级分析的支持有限(Limited support for advanced analytics). 企业希望使用他们的数据仓库数据回答预测性问题, 例如, “我应该向哪些客户提供折扣?” 尽管对ML和数据管理的融合进行了大量研究, 但没有一个领先的机器学习系统, 如TensorFlow, PyTorch和XGBoost, 能够在数据仓库上很好地工作. 与提取少量数据的BI查询不同, 这些系统需要使用复杂的非SQL代码处理大型数据集. 通过ODBC/JDBC读取这些数据是低效的, 而且没有办法直接访问数据仓库内部的专有格式. 对于这些用例, 数据仓库供应商建议将数据导出到文件, 这进一步增加了复杂性和陈旧性(增加了第三个ETL步骤!). 或者, 用户可以针对开放格式的数据湖数据运行这些系统. 然而, 它们会失去数据仓库丰富的管理特性, 比如ACID事务, 数据版本控制和索引.
- 总拥有成本(Total cost of ownership). 除了为连续ETL付费之外, 用户还要为复制到数据仓库的数据支付双倍的存储成本, 而且商业仓库将数据锁定为专有格式, 这增加了将数据或工作负载迁移到其他系统的成本.
Lakehouse架构概览
由于当前数据平台架构存在的各种问题, 论文提出了一个问题: 有没有可能将基于标准开放数据格式(如Parquet和ORC)的数据湖转变为高性能系统, 既能提供数据仓库的性能和管理功能, 又能提供来自高级分析工作负载的快速直接I/O?
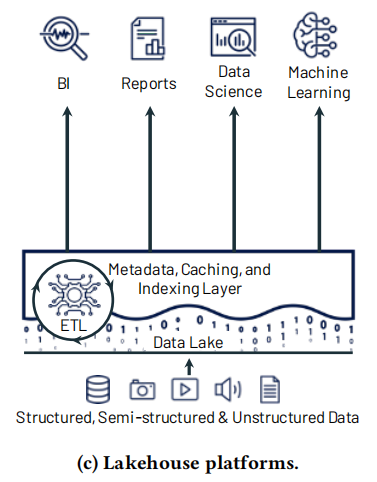
当然, 论文的作者认为上述问题显然是可能的. 于是就出现了如下这种Lakehouse平台架构. 它在数据湖之上添加了一层轻量级的封装, 从而能够支持数据仓库类的SQL查询, 也能提供高性能的数据I/O供机器学习系统使用.
Lakehouse必备的技术条件
上述Lakehouse数据平台架构的实现是需要一定技术条件作为支撑的, 论文指出了三个重要的技术条件, 它们是Lakehouse时代来临的重要保障.
- 数据湖上的可靠数据管理: Lakehouse需要能够存储原始数据, 类似于今天的数据湖, 同时支持管理这些数据的ETL/ELT流程, 以提高其分析质量. 传统来说, 数据湖将数据作为半结构化格式的”一堆文件”来管理, 因此很难提供一些关键的管理功能来简化数据仓库中的ETL/ELT, 如事务, 回滚到旧表版本和零拷贝克隆. 然而, 最近的一系列系统, 如Delta Lake和Apache Iceberg, 提供了数据湖的事务视图, 并启用了管理功能. 当然, 人们仍然需要做艰苦的工作来编写ETL/ELT逻辑来使用Lakehouse创建经过管理的数据集, 但总体上ETL步骤更少, 并且分析者还可以轻松且高效地查询原始数据表, 这与第一代分析平台中的情况非常相似.
- 支持机器学习和数据科学: ML系统对数据湖格式直接读取的支持, 已经使它们处于有效访问Lakehouse的良好位置. 此外, 许多ML系统采用DataFrame作为操作数据的抽象, 最近的系统设计了声明式DataFrame API, 这些API允许在ML工作负载中执行数据访问的查询优化. 这些API使ML工作负载能够直接受益于Lakehouse中的许多优化.
- SQL性能: Lakehouse将需要在过去十年(或者长期来说, 是为直接访问而公开的一些其他标准格式)积累的海量Parquet/ORC数据集的基础上提供最先进的SQL性能. 相比之下, 传统的数据仓库接受SQL, 可以自由地优化一切, 包括专有的存储格式. 尽管如此, 我们表明可以使用各种技术来维护有关Paracquet/ORC数据集的辅助数据, 并在这些现有格式中优化数据布局, 以获得具有竞争力的性能. 我们展示了在Paracquet上的SQL引擎(Databricks Delta Engine)的结果, 该引擎在TPC-DS上的性能超过了领先的云数据仓库.
从上述条件可以看出, 要使Lakehouse平台成为现实, 需要在存储和计算两个方面都有完备的技术支撑.
- 存储层面, 在传统的数据湖上需要支持事务, 索引, 多版本等高级功能. 同时还要支持声明式的DataFrame API以支持机器学习系统的直接访问. 目前开源的Delta Lake, Apache Hudi/Iceberge等都是期望解决这类问题的系统, 它们在传统数据湖之上提供了table format.
- 计算层面, 需要有高效的SQL引擎, 能够直接访问优化后的数据湖中的数据, 并且提供与数据仓库相当的查询性能. Databricks采用了自研的Delta Engine, 当然也可以采用开源的Spark/Flink计算引擎, 或Presto等MPP引擎, 或混合引擎, 并根据具体的查询场景适配最优的引擎. 阿里云的DLF, 以及火山引擎的LAS实际上都采用了混合引擎的解决方案.
Lakehouse架构及特性
Lakehouse的定义
基于上述知识, 论文给Lakehouse下了一个明确的定义: 我们将Lakehouse定义为基于低成本和可直接访问存储的数据管理系统, 它还提供传统的分析DBMS管理和性能特性, 如ACID事务, 数据版本控制, 审计, 索引, 缓存和查询优化.
由上述定义可以看出, Lakehouse结合了数据湖和数据仓库的主要优点: 开放式格式的低成本存储, 可由前者的各种系统访问, 而后者具有强大的管理和优化功能.
值得注意的是, Lakehouse特别适合存储与计算分离的云环境: 不同的计算应用程序可以在完全独立的计算节点(例如, ML的GPU集群)上按需运行, 同时直接访问相同的存储数据. 然而, 也可以在HDFS等内部存储系统上实现Lakehouse.
Lakehouse的架构
论文提出的Lakehouse架构如下图所示. 在传统数据湖的基础之上, 增加了Metadata层, 这一层不仅在廉价的数据湖存储上增加了事务, 多版本等功能, 并且还能提供缓存, 辅助数据结构(如索引和统计信息), 以及数据布局优化. 在Metadata层之上, 可以通过SQL API直接访问数据湖中的原始数据用于BI应用, 也可以通过声明式的DataFrame API读取原始数据用于数据科学和机器学习类应用.
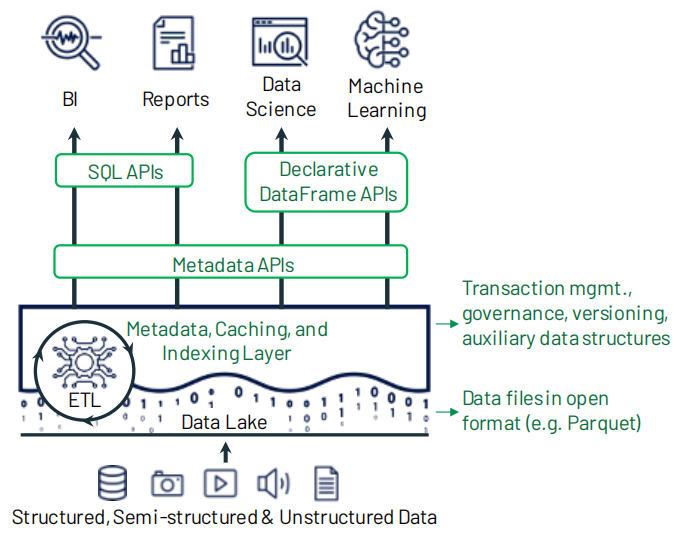
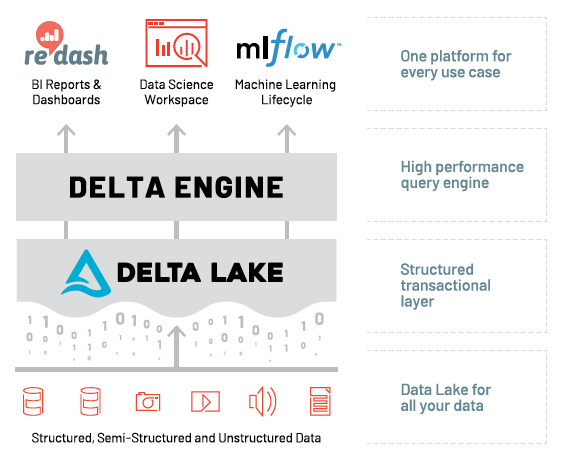
可以看出, Lakehouse架构有很大的灵活性, 由于存储和计算分离, 在实现Lakehouse架构时, 可自由组合多种存储和计算引擎. 论文详细介绍了Databricks在Lakehouse平台架构上的实践, 其采用的各个引擎如下图所示.
- Metadata层采用Delta Lake, 目前已经开源, 同类的开源产品还有Apache Iceberge/Hudi, 也就是说在构建Lakehouse时可以采用任意一个上述系统.
- 计算引擎是Databricks内部基于C++自研的Delta Engine, 完全兼容Spark SQL, 并且提供了大量的查询优化. 也可以采用开源的Spark/Flink或Presto等引擎代替.
Metadata Layers for Data Management
Lakehouse中的Metadata层构建在现有的数据湖之上, 一般与现有的存储格式如Parquet/ORC兼容, 并提供数据管理功能, 如:
- 事务支持, 零拷贝克隆, 时间旅行;
- 数据约束, 如域约束等, 可以提升数据湖中的数据质量;
- 权限验证, 如觉得哪个用户可以访问哪张表.
目前开源的Delta Lake, Apache Iceberg/Hudi, 都支持上述的全部或部分功能. 不过论文也指出了由于数据湖的Metadata层由于刚刚发展, 也还存在很多问题值得进一步解决. 比如, Delta Lake目前将事务日志存储在与底层数据湖相同的对象存储上, 由于对象存储的高延时性, 如果可以把事务日志存储在更快的存储引擎上则可能进一步降低数据湖的访问延迟; Delta Lake, Iceberge和Hudi一次只支持一张表上的事务, 但应该可以扩展它们以支持跨表事务; 优化事务日志的格式和被管理对象的大小也是有待解决的问题.
SQL Performance in a Lakehouse
Lakehouse架构能否成功的一个重要因素是能否在数据湖之上实现媲美数据仓库的SQL查询效率. 因为SQL查询几乎是一个数据平台不可或缺的, 而且有很大一部分SQL查询对延迟有很高的要求, Lakehouse去掉了专用于SQL查询的数据仓库系统之后提供与之相近的SQL查询性能是一个重要的挑战. 而对于高级分析和机器学习系统而言, 这类系统对数据读取的实时性要求没有那么高, 在数据湖之上提供供这类系统读取数据的接口不会有很大的挑战.
论文也指出了对于如何在放弃传统DBMS设计中的很大一部分数据独立性的同时, 提供最先进的SQL性能, 是受很多因素影响的. 论文提出了几种优化技术, 这几种技术已经在Databricks的Delta Engine中得到了实现, 以下是论文原文的翻译.
- 缓存(Caching): 当使用诸如Delta Lake之类的事务性Metadata层时, Lakehouse系统可以安全地将来自云对象存储的文件缓存在更快的存储设备上, 例如处理节点上的SSD和RAM. 正在运行的事务可以很容易地确定缓存的文件何时仍然可以读取. 此外, 缓存可以采用代码转换的格式, 这种格式对于查询引擎的运行更有效, 与传统”封闭世界”数据仓库引擎中使用的任何优化相匹配. 例如, 我们在Databricks的缓存部分解压缩了它加载的Parquet数据.
- 辅助数据(Auxiliary data): 尽管Lakehouse需要公开直接I/O的表格存储格式, 但它可以在其完全控制的辅助文件中维护有助于优化查询的其他数据. 在Delta Lake和Delta Engine中, 我们为表中的每个数据文件维护列最小-最大统计信息, 这些数据文件位于用于存储事务日志的同一个Parquet文件中, 这使得在基本数据按特定列聚集时可以使用数据跳过优化. 我们还在实现基于Bloom Filter的索引. 人们可以想象在这里实现广泛的辅助数据结构, 类似于索引”原始”数据.
- 数据布局(Data layout): 数据布局对访问性能影响很大. 即使我们确定了Parquet等存储格式, Lakehouse系统也可以优化多种布局决策. 最明显的是记录排序: 哪些记录聚集在一起, 因此最容易一起读取. 在Delta Lake中, 我们支持使用个体维度或空间填充曲线(如z阶和希尔伯特曲线)来排序记录, 以提供跨多个维度的局部性. 您还可以想象支持在每个数据文件中以不同顺序放置列的新格式, 为不同的记录组选择不同的压缩策略或其他策略.
论文提供了使用Delta Lake和Delta Engine时的SQL查询性能, 下图是Lakehouse架构与四种云数据仓库的SQL查询性能和成本对比. 从中可以看到, Lakehouse具有最低的成本, 其SQL查询性能甚至比三个云数据仓库更好.
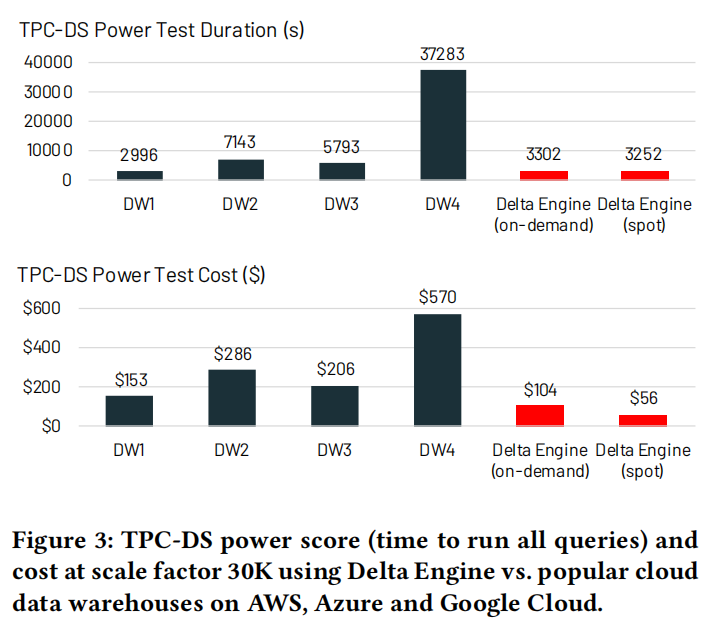
根据上述分析也可以看出, 性能强悍的计算引擎是Lakehouse能否成功的关键. Databricks的Delta Engine目前尚未开源, 而Spark/Flink/Presto等产品虽然亦可作为Lakehouse架构中的计算引擎, 但是它们还存在诸多优化的余地. 笔者也认为未来在计算引擎的查询优化方面是一个重要的研究热点.
Efficient Access for Advanced Analytics
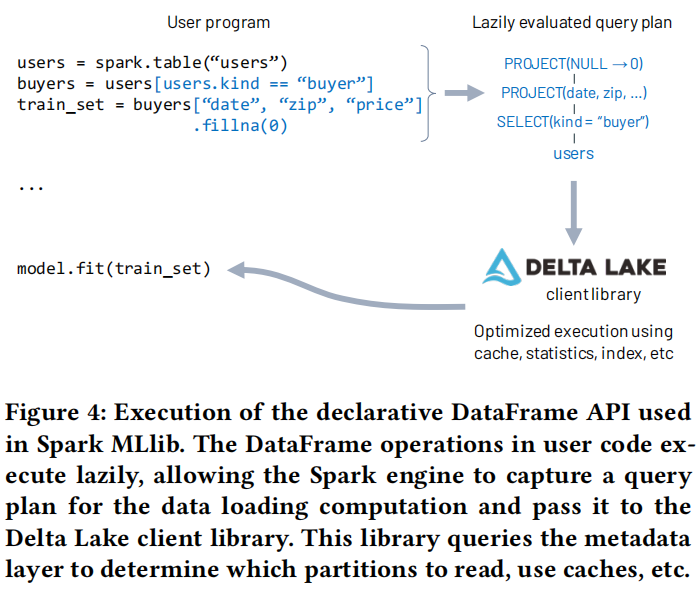
高级数据分析库通常使用命令式代码编写, 而不能使用SQL运行, 但仍需要访问大量数据. 论文也指出了这当中一个有趣的研究问题是: 如何设计这些库中的数据访问层, 以最大限度地提高运行在上面的代码的灵活性, 但仍然可以从Lakehouse中的优化机会中获益.
Databricks成功使用的一种方法是在这些库中提供声明式的DataFrame API, 它将数据读取计划映射为等价的Spark SQL查询计划, 这样就可以从Delta Lake和Delta Engine的优化中获益. 其流程如下.
机器学习API的情况就相对复杂了, 有些数据访问API如Tensorflow的tf.data并不支持数据的查询语言. 最近的系统工作表明, 保持现代查询加速器得到很好的利用, 特别是对于ML推断, 可能是一个困难的问题, 因此Lakehouse访问库将需要解决这一挑战. 论文也指出了, 目前仍然需要标准接口来让数据科学家充分利用Lakehouse(甚至数据仓库)中的强大数据管理功能. 例如, 在Databricks, 已经将Delta Lake与MLflow中的ML实验跟踪服务集成在一起, 让数据科学家轻松地跟踪实验中使用的表版本, 并在以后重现该版本的数据.
Lakehouse的特性
根据上述内容, 我们可以对Lakehouse的特性做一个总结, 不过论文中并没有描述相关内容, 以下内容来自Databricks的博文What Is a Lakehouse?
Lakehouse具有以下主要特征:
- 事务支持(Transaction support): 在企业的Lakehouse中, 许多数据管道经常会并发地读写数据. 对ACID事务的支持确保了多方并发读写数据(通常使用SQL)时的一致性.
- 模式执行和治理(Schema enforcement and governance): Lakehouse应该有一种支持模式执行和演化的方法, 支持DW模式体系结构, 比如星型/雪花型模式. 系统应该能够推断数据完整性, 并且应该有健壮的治理和审计机制.
- BI支持(BI support): Lakehouse支持直接在源数据上使用BI工具. 这减少了过时性, 减少了延迟, 并降低了必须操作数据湖和数据仓库中的两个数据副本的成本.
- 存储与计算分离(Storage is decoupled from compute): 实际上, 这意味着存储和计算使用独立的集群, 因此这些系统能够扩展到更多并发用户和更大的数据规模. 一些现代数据仓库也具有这种特性**.**
- 开放性(Openness): 它们使用的存储格式是开放和标准化的, 如Parquet, 它们提供了一个API, 因此各种工具和引擎, 包括机器学习和Python/R库, 可以有效地直接访问数据.
- 支持从非结构化数据到结构化数据的各种数据类型(Support for diverse data types ranging from unstructured to structured data): Lakehouse可用于存储, 精化, 分析和访问许多新数据应用程序所需的数据类型, 包括图像, 视频, 音频, 半结构化数据和文本.
- 支持不同的工作负载(Support for diverse workloads): 包括数据科学, 机器学习, SQL和分析. 可能需要多个工具来支持所有这些工作负载, 但它们都依赖于相同的数据存储库.
- 端到端流(End-to-end streaming): 实时报告是许多企业的标准. 对流媒体的支持消除了为实时数据应用提供服务的独立系统的需要.
总结
本文是对Databricks的Lakehouse论文的阅读总结. 从论文中我们可以看到, Lakehouse这一数据平台架构的产生是多种因素共同推动的, 首要的原因是当前的数据平台架构复杂性高, 需要多次ETL, 不仅增加了数据延时, 也引入了更多出错的风险; 其次, 随着数据量的不断增长, 数据种类的不断增多, 无论是第一代还是第二代数据平台架构都不能很好地用于高级数据分析和机器学习; 另外, 随着云计算技术的发展, Lakehouse这种更为彻底的存算分离架构更适合云环境.
尽管Lakehouse看起来是一个更完美的架构, 但是目前来说由于开源计算引擎在数据湖上的查询性能, 工具的完善程度等原因, Lakehouse尚未得到广泛的使用. 并且在流批一体的存储方面, 数据湖还存在进步的空间, 因此目前大多实时应用还运行在支持实时数据写入的数据仓库中. 不过笔者也坚信, 随着数据湖存储和计算引擎的发展, 数据湖这种低成本的方案未来一定会被广泛使用. 与Lakehouse相关的存储和处理技术未来也是大数据系统领域的研究热点.
参考
[1] What Is a Lakehouse?
[2] Delta Engine Introduction and Overview of How it Works
[3]《 Delta Lake 数据湖专题系列5讲》文章回顾
[4] 深度对比 Delta、Iceberg 和 Hudi 三大开源数据湖方案
[5] 湖仓一体会成为企业的必选项吗?
评论 0
按时间正序正在加载讨论…